数字工具箱 ·
Claude Code 的使用实践之如何节省 token
- 简单版结论:要多开新窗口,不要吝啬,应开尽开。
- 写记忆库 ➕ 换窗能有效节省 token。
- 为什么呢?因为模型有个缓存过期时间(TTL)的概念,类似于商品的保质期。保质期内消息新鲜,发消息便宜,此时缓存被命中。过了保质期,商品过期消息缓存过期,此时重新加载缓存导致消耗 token 变多。
- 下面以 Claude 为例:
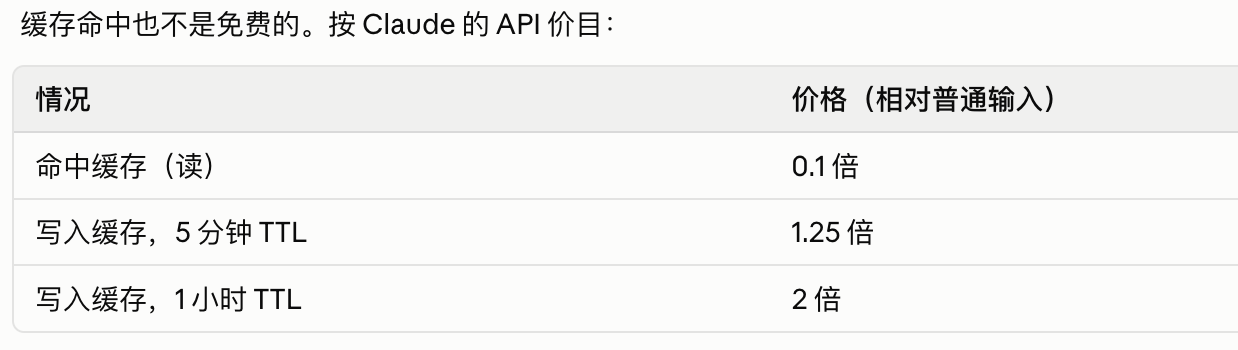
- Codex 的缓存命中时间是 5-10 分钟,也就是 5 分钟一过,你没有接上继续使用,Cache 就当做不命中了。Claude 默认 5 分钟、命中刷新,付费可提至 1 小时。Gemini 默认 1 小时。阿里 / Kimi 默认 5 分钟,智谱约 1 小时,DeepSeek 是几小时到几天(这方面 ds 独树一帜)。
- 缓存过期(Cache Miss):如果超过了这段话里写的 TTL,服务器为了释放内存就会把这部分缓存清理掉。这样就相当于商品过期了。下一次你再发消息,模型就必须“重新加载(重新计算)”全部历史文本,从而完整消耗 Token 并收取全额费用。
- 缓存指的是 KV Cache:模型把已经计算过的历史文本的键和值矩阵保存在内存中。下次你再提问时,模型直接复用这部分计算结果,不再重复计算这部分 Token 的注意力。
- 原生的 KV Cache 通常只在单次会话内或者极短时间内有效。而这里的缓存,讨论的是各大厂商推出的带有生存时间(TTL, Time to Live)的持久化 / 共享上下文缓存技术。
- 缓存是按账号(组织)隔开的,换了号,哪怕一秒钟前刚用过,缓存也一定不命中。另外,过了缓存时长(TTL)没接着用,同样会不命中。两件事任何一件发生,接上后的第一句都要把整段历史重新写一遍缓存。
- 什么时候换窗口,什么时候接着用?
- 离开不到 TTL,活还没干完:接着用,缓存是热的,最便宜。
- 离开超过 TTL,或者要换账号:反正要重写缓存,不如开新窗口。先让我把还没落地的结论写进记忆或交接文件,新窗口只读这一小份。
- 同一个窗口越聊越长、话题已经换了好几轮:就算不离开也值得换。不想换窗口的话,/compact 能把历史压成摘要,效果类似。